Daten importieren
Alle Wege enden am selben Ort: als Apache-Iceberg-Tabelle im Lakehouse, versioniert über Nessie und den Richtlinien unterworfen. Verschieden ist nur, woher die Daten kommen.
Auf dieser Seite
Ein Einstieg für Tabellen und Dokumente
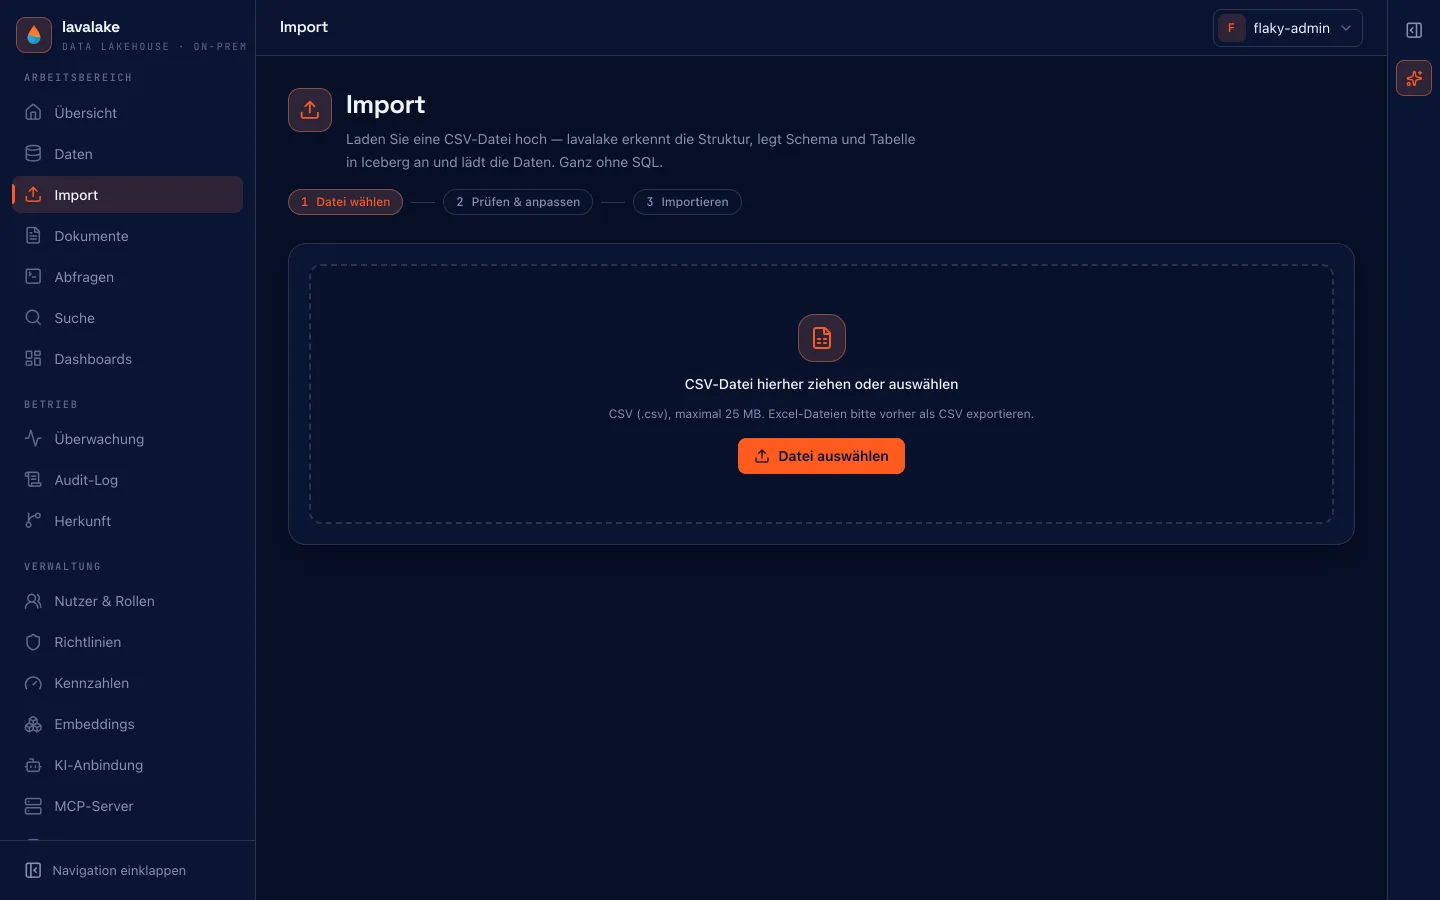
Unter „Daten hinzufügen → Dateien hochladen“ wählen Sie CSV oder XLSX für den Tabellenimport und PDF, DOCX, TXT oder Markdown für die Dokumentverarbeitung. XLSX liest das erste Arbeitsblatt; ältere XLS-Dateien vorher als XLSX oder CSV speichern.
Abnahme der Datenbankwege
PostgreSQL, MySQL, SQL Server und Snowflake wurden gegen echte Systeme geprüft. Für SAP, CRM, DATEV und die BI-Zielanwendungen stehen Praxistests weiter aus. PostgreSQL-CDC ist im Compose-Betrieb zuschaltbar; geplante Delta-Läufe bleiben ein eigener Importweg.
Excel, CSV und Dokumente
Der übliche Einstieg, zu finden unter Daten → „+ Daten hinzufügen“. Der Assistent liest die Datei, schlägt eine Struktur vor und lässt sie vor dem Laden überarbeiten – ohne eine Zeile SQL.
- Typen überschreiben, wo die Erkennung danebenliegt.
- Spalten umbenennen oder weglassen.
- Null-Kennungen festlegen – etwa „N/A“ oder „-“ als leer statt als Text.
- Leerzeichen an den Rändern entfernen und Duplikate verwerfen.
Große Dateien melden ihren Fortschritt zeilenweise während des Ladens. Ein laufender Import bleibt sichtbar, auch wenn Sie inzwischen auf einer anderen Seite arbeiten – er wird nicht abgebrochen, weil die Ansicht wechselt.
Datenbank-Konnektoren
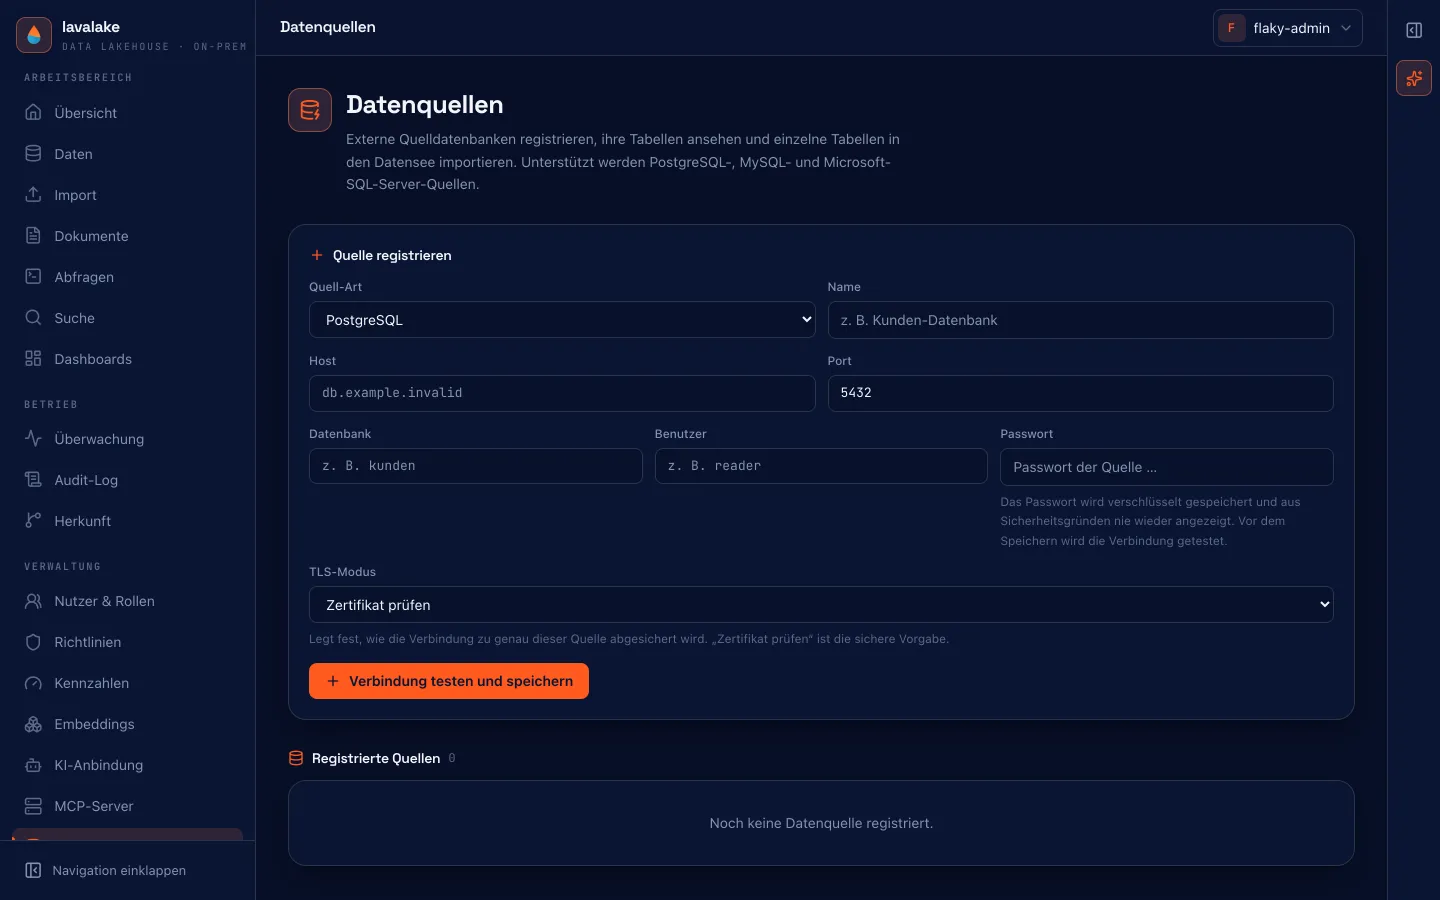
Unter Verbindungen → Datenquellen lassen sich bestehende Datenbanken anmelden: PostgreSQL, MySQL und Microsoft SQL Server. Danach werden einzelne Tabellen daraus in das Lakehouse übernommen.
| Eigenschaft | Verhalten |
|---|---|
| Zugangsdaten | AES-256-GCM verschlüsselt gespeichert, nie zurückgegeben oder protokolliert. |
| Verbindung | Ausschließlich lesend. |
| Transport | TLS mit Zertifikatsprüfung als Voreinstellung, je Quelle auf require oder disable umstellbar. |
| Verbindungstest | Läuft durch den Egress-Schutz – Link-Local- und Cloud-Metadaten-Adressen sind ausgeschlossen. |
SAP Business One
SAP wird wie jede andere Quelle angemeldet – Adresse des Service Layers, Mandantendatenbank, SAP-Benutzer, TLS-Modus. Seine Entitäten wie Items, BusinessPartners oder Orders laufen danach durch dieselbe Import-Pipeline wie alles andere: es gibt keinen zweiten Importweg und keine zweite Typ-Allowlist.
Typen kommen aus $metadata
Die EDM-Typen des Service Layers werden auf dieselbe Allowlist abgebildet wie die der JDBC-Quellen, Dezimalstellen eingeschlossen. Was die Tabelle nicht kennt, landet als Text – nie als geratene Zuordnung.
SAP S/4HANA
Unter Verbindungen → Datenquellen wählen Sie SAP S/4HANA und tragen Gateway-Adresse, OData-Dienstpfad, Zugangsdaten und optional sap-client ein. Pro Quelle wird ein Dienst angebunden. OData V2 und V4 werden aus $metadata erkannt; der Mandant bleibt über alle Seiten des Imports erhalten. Es gibt keinen Dienst-Katalog und keinen ODP-/CDS-Delta-Extraktor.
DATEV-Exportdateien
EXTF- und DTVF-Dateien werden im Dateiimport automatisch erkannt. Die erste Zeile enthält Metadaten, die zweite die Spaltennamen; Windows-1252 wird berücksichtigt. Die Buchungswerte werden unverändert übernommen: Soll/Haben wird nicht in Vorzeichen umgerechnet und aus einem Belegdatum kein Jahr ergänzt. DATEVconnect und die DATEV-Cloud-API sind nicht Bestandteil der Anbindung.
Praxistests der neuen Anbindungen
SAP Business One, S/4HANA und DATEV sind implementiert und mit nachgebauten Gegenstellen beziehungsweise Testdateien geprüft. Ein Test gegen echte SAP-Systeme und einen echten DATEV-Export steht noch aus. Planen Sie vor dem Einsatz einen kleinen Import und den Abgleich mit dem Original ein.
SAP S/4HANA, DATEV und CRM-Systeme
Neben SAP Business One lesen weitere Fachsysteme über denselben Weg: SAP S/4HANA über den OData-Dienst des Gateways, Microsoft Dynamics 365 über Dataverse, dazu HubSpot und Salesforce. DATEV-Dateien erkennt der Import-Assistent am Format (EXTF/DTVF) und liest Spaltennamen und Umlaute richtig, statt sie als gewöhnliche CSV zu behandeln.
OAuth statt Passwort in der Konfiguration
Für die SaaS-Quellen wird eine OAuth-Verbindung einmal hinterlegt und danach wiederverwendet. In keiner Konfigurationsdatei steht ein Passwort.
Dokumente
Unter Daten → Dokumente werden PDF-, Word- und Textdateien hochgeladen. Sie werden extrahiert, in Abschnitte zerlegt und eingebettet; das Ergebnis liegt als reguläre Tabelle im Lakehouse. Damit gelten Suche und Richtlinien für Dokumentinhalte genauso wie für Tabellendaten.
Extraktion läuft abgeschottet
PDF und Word werden in einem eigenen Worker mit hartem Zeitlimit gelesen. Ein präpariertes Dokument kommt über diesen Worker nicht hinaus.
MCP-Ingestion
Ist ein MCP-Server angemeldet – etwa ein SAP-MCP –, lassen sich tabellarische Ergebnisse eines seiner freigegebenen Werkzeuge unter Verbindungen → MCP-Ingestion direkt in das Lakehouse ziehen. Nur ausdrücklich eingeschaltete Werkzeuge stehen zur Auswahl.
lavaflow: Strecken zusammenklicken
Unter Jobs → lavaflow liegt ein visueller Baukasten für ETL-Strecken: Quelle, Schritte und Ziel werden zusammengeklickt statt abgetippt. Gedacht für Aufbereitungen, die sich wiederholen und die sonst als SQL-Schnipsel in irgendeiner Datei landen würden.
Datei-Crawler
Statt Dateien einzeln hochzuladen, kann ein eingehängtes Verzeichnis angemeldet werden. Passende Dateien laufen anschließend durch dieselben Pipelines wie ein Upload. Der Crawler bleibt auf den angemeldeten Pfad beschränkt und ist gegen das Austauschen von Dateien zwischen Prüfung und Zugriff abgesichert.
Jeder Weg bleibt nachvollziehbar
Unter Betrieb → Herkunft steht später, woraus eine Tabelle entstanden ist und wer sie seither gelesen hat.
Stand: Diese Seite beschreibt lavalake 0.201.0. Produkt und Dokumentation liegen in getrennten Repositories – im Zweifel gilt, was die Konsole zeigt.
Etwas fehlt?
Wenn diese Seiten Ihre Frage nicht beantworten, zeigen wir die Plattform in einer halben Stunde an Ihrem Fall.
Demo vereinbaren