lavaflow
Vom Rohdatensatz zur Auswertung — zusammengeklickt
Quelle wählen, Schritte hinzufügen, Ziel setzen — fertig ist die Aufbereitung. lavaflow macht aus Rohdaten eine belastbare Tabelle, sichtbar auf einer Fläche, versioniert wie Quelltext und eingeplant wie jeder andere Termin. Gebaut wird mit der Maus, mit Python, JavaScript oder SQL — oder vom Assistenten.
- Wo
- Konsole → Automatisieren → lavaflow
- Schritte
- Python, JavaScript, SQL, Regeln und KI
- Quellen
- Dateien, Tabellen, Verbindungen und HTTP-APIs
- Ziele
- Tabelle im See oder Datei zum Weitergeben
- Bauen
- per Maus, per Code oder vom Assistenten
DWH Automation: Datenflüsse wiederholbar ausführen
DWH Automation verbindet das Laden, Aufbereiten und Aktualisieren von Daten zu wiederholbaren Abläufen. In lavaflow legen Sie Quellen, Verarbeitungsschritte und Ziele fest, testen den Entwurf und veröffentlichen eine Version. Zeitpläne und verkettete Jobs übernehmen die regelmäßige Ausführung; der Laufverlauf hilft bei der Fehlersuche.
Datenqualität verbessern, bevor Daten ins Reporting gelangen
Ein sinnvoller Einstieg sind konkrete Regeln für die Daten, auf denen Ihre Kennzahlen beruhen. Der Qualitätsprüfungsschritt in lavaflow prüft zum Beispiel erlaubte Werte, Ganzzahlen und Textlängen. Erst wenn die Prüfung vollständig erfolgreich ist, reicht dieser Schritt die Daten weiter.
Beispiel: Eine Spalte für den Bestellstatus soll nur freigegebene Statuswerte enthalten. Eine Werteliste erkennt unerwartete Schreibweisen vor dem nächsten Verarbeitungsschritt. Prüfen Sie anschließend die Ursache in der Quelle oder passen Sie die Aufbereitung an und testen Sie den Ablauf erneut. So wird Datenqualität zu einem überprüfbaren Teil des Datenflusses.
Pyro bereitet Daten auf
Beschreiben Sie die gewünschte Transformation und lassen Sie Pyro Python vorschlagen. Nach Ihrer Prüfung bleibt der Code im Ablauf gespeichert und läuft bei späteren Ausführungen ohne erneuten KI-Aufruf. Für Klassifizieren, Extrahieren und Zusammenfassen steht zusätzlich ein Pyro-Schritt bereit, der bei jedem Lauf das gewählte Modell verwendet.
Vom Datenfluss zum Geschäftsablauf
Qualitätsprüfungen, Prognosen und HTTP-Anfragen ergänzen die Aufbereitung. Plattformaktionen starten Jobs, rufen veröffentlichte Unterflows auf, aktualisieren Dashboards und erzeugen Berichte. Entwurf und veröffentlichte Fassung bleiben getrennt; Testläufe und die Ergebnisse einzelner Schritte helfen beim Prüfen.
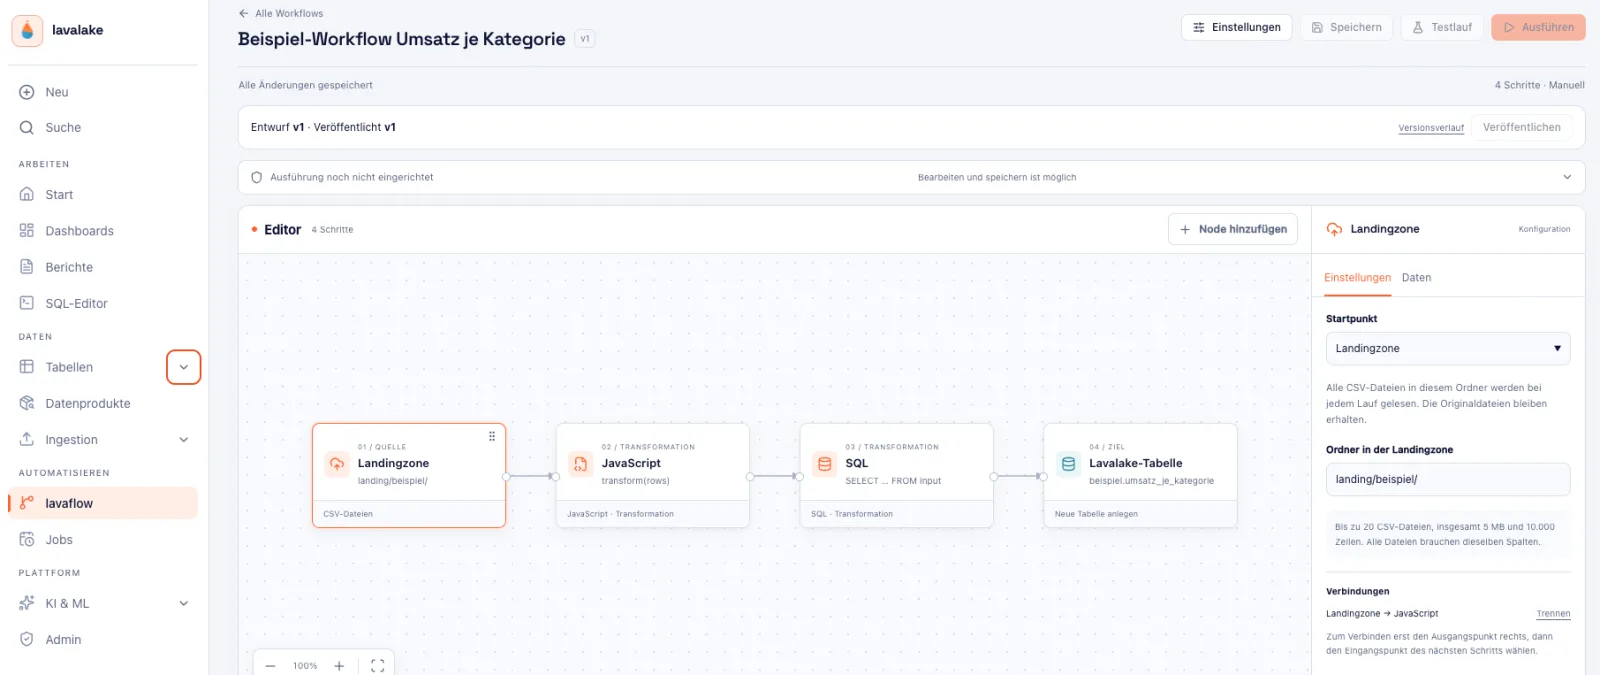
In Minuten gebaut
Ein Ablauf verbindet mehrere Quellen, Verarbeitungsschritte und Ziele. Bedingungen und Switch-Knoten verteilen Zeilen auf passende Zweige; Zusammenführen bringt Datenströme wieder zusammen. Jeder Schritt lässt sich einzeln ausprobieren, während man baut, und die Fläche zeigt jederzeit, was mit den Daten geschieht. Wer sie in einem halben Jahr öffnet, versteht sie in wenigen Sekunden — und kann sie weiterbauen.
| Baustein | Wofür |
|---|---|
| Dateiablage | Neue CSV-Dateien aus einem Ordner aufnehmen, sobald sie dort landen. |
| Tabelle als Quelle | Auf dem aufsetzen, was schon im See liegt. |
| Python, JavaScript | Umformen in der Sprache, die im Haus ohnehin gesprochen wird. |
| SQL | Umformen mit den Mitteln, die Ihre Analystinnen und Analysten längst beherrschen. |
| Spaltenzuordnung | Umbenennen, Typen setzen, Spalten weglassen — ohne eine Zeile Code. |
| Tabelle als Ziel | Anlegen, anfügen, ersetzen oder per Upsert abgleichen. |
| Dateiausgabe | Ergebnisse als CSV, Excel, JSON oder XML bereitstellen. |
Jede Fassung bleibt
Gearbeitet wird am Entwurf, veröffentlicht wird eine Fassung — mit Versionsverlauf. Jede frühere Fassung bleibt einsehbar und jederzeit wieder einsetzbar. Umbauen heißt hier: ausprobieren, vergleichen, veröffentlichen.
Wer eine Strecke ändert, ändert, was morgen in den Zahlen steht. Deshalb trägt jede Veröffentlichung Datum, Person und Fassung — nachlesbar, auch Jahre später.
Der Assistent baut den ersten Entwurf
Beschreiben Sie, was aus welcher Datei werden soll, und der eingebaute KI-Assistent setzt die Schritte. Der Vorschlag steht fertig auf der Fläche: ansehen, anpassen, veröffentlichen. Aus einer Idee im Gespräch wird so in einem Zug eine laufende Aufbereitung.
Gehört zur Plattform
lavaflow liegt in derselben Installation wie alles andere: dieselbe Anmeldung, dieselbe Audit-Kette, dieselben Richtlinien auf den Tabellen, die es liest und schreibt. Es läuft dort, wo Ihre Daten ohnehin liegen — in Ihrem Rechenzentrum, auf Ihrer Hardware.
- Ein Produkt, ein Anbieter, ein Vertrag — und die Daten bleiben im Haus.
- Dieselben Rollen und Rechte wie im Rest der Plattform.
- Jeder Lauf und jede Veröffentlichung im revisionssicheren Protokoll.
- Strecken lassen sich als Regeltermin einplanen und verketten.
DataOps: Änderungen prüfen und nachvollziehbar betreiben
DataOps verbindet die Zusammenarbeit an Daten mit wiederholbaren Prüf- und Betriebsabläufen. In lavaflow unterstützen getrennte Entwürfe und Veröffentlichungen, Testläufe und Laufverläufe diese Arbeitsweise. Vereinbaren Sie im Team, wer Änderungen prüft, wer sie veröffentlicht und wer fehlgeschlagene Läufe bearbeitet. Die Plattformfunktionen ergänzen diese Zuständigkeiten.
Wo das in der Plattform sitzt
Dasselbe Bild wie auf der Startseite: eine Plattform, ein Rechtemodell, ein Speicher.
- Zugang: Konsole (SPA) · SQL-Worksheet · Dashboards · KI-Assistent · MCP-Server – alles hinter einem Reverse-Proxy
- Identität & Governance: Keycloak OIDC · Token Exchange nach RFC 8693 · Row-Access- und Masking-Policies · WORM-Audit · Lineage
- Compute: Trino unter Ihrer Identität · Leistungsklassen S, M und L im Compose-Stapel
- Katalog & Tabellenformat: Apache Iceberg mit Nessie: ACID · Time Travel · Branching · Schema Evolution · offen für Spark, Flink, Trino
- Storage & Index: S3-kompatibel (MinIO, Ceph, NetApp StorageGRID, Dell ECS) · PostgreSQL mit pgvector als Vektorindex
Sehen, statt nachzulesen
In einer halben Stunde zeigen wir die Plattform an Ihren Fragen – Ingestion, Rechte, Suche, Agent. Ohne Folien.
Live-Demo buchen